
利用類別分組視覺化,針對護眼行為 Blue_Light_Filter_Used(是否使用抗藍光濾鏡)進行分組切片,探討其對眼睛乾澀程度(Eye_Dryness_Level)與眼痛程度(Eye_Pain_Level)的實際分佈差異。
一、實作前情境:打破「科技玄學」,用真實分組說話
在Day9的相關係數矩陣中,我們發現單純看連續數值的線性相關幾乎無法解釋眼部症狀(r ≈ 0.01)。這引出了一個大眾高度關注的生活議題:
市面上充斥著各式各樣的「抗藍光眼鏡」、「螢幕抗藍光保護貼」或作業系統內建的「夜間護眼模式」,許多人認為只要開啟抗藍光濾鏡,眼睛就不容易乾澀、酸痛。
在我們的資料集中,剛好有兩組充分的樣本量:
有使用抗藍光濾鏡組(Yes):303人(60.6%)
未使用抗藍光濾鏡組(No):197人(39.4%)
今天我們就透過分組對比,直接檢視抗藍光濾鏡在乾澀與眼痛兩個指標上的表現是否存在統計上的實質差異。
二、撰寫抗藍光分組視覺化與統計腳本
在Colab中新增程式碼儲存格,建立1列2行的分組小提琴圖與箱形圖複合呈現:
# ==========================================
# Day 10:抗藍光濾鏡對眼部症狀影響分析
# ==========================================

import matplotlib.font_manager as fm
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

# 確保引用已下載的中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 1. 建立 1x2 畫布佈局
fig, axes = plt.subplots(1, 2, figsize=(15, 6))
sns.set_theme(style="whitegrid")

# 調色盤設定:No使用淺橘紅,Yes使用護眼藍
custom_palette = {'No': '#e06666', 'Yes': '#4a90e2'}
category_order = ['No', 'Yes']

# --- 圖 1:抗藍光濾鏡 vs 眼睛乾澀程度 ---
sns.boxplot(
    data=df,
    x='Blue_Light_Filter_Used',
    y='Eye_Dryness_Level',
    hue='Blue_Light_Filter_Used',  # 指定 hue 消除 FutureWarning
    order=category_order,
    palette=custom_palette,
    legend=False,  # 關閉圖例
    width=0.45,
    boxprops=dict(alpha=0.8),
    ax=axes[0],
)
axes[0].set_title(
    '抗藍光濾鏡使用 vs 眼睛乾澀程度',
    fontproperties=my_font,
    fontsize=14,
    fontweight='bold',
)
axes[0].set_xlabel(
    '是否使用抗藍光濾鏡 (Blue_Light_Filter_Used)',
    fontproperties=my_font,
    fontsize=12,
)
axes[0].set_ylabel('乾澀自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[0].set_xticks([0, 1])  # 先固定刻度消除 UserWarning
axes[0].set_xticklabels(
    ['未開啟 (No)', '使用 (Yes)'], fontproperties=my_font, fontsize=11
)

# --- 圖 2:抗藍光濾鏡 vs 眼痛程度 ---
sns.boxplot(
    data=df,
    x='Blue_Light_Filter_Used',
    y='Eye_Pain_Level',
    hue='Blue_Light_Filter_Used',  # 指定 hue 消除 FutureWarning
    order=category_order,
    palette=custom_palette,
    legend=False,  # 關閉圖例
    width=0.45,
    boxprops=dict(alpha=0.8),
    ax=axes[1],
)
axes[1].set_title(
    '抗藍光濾鏡使用 vs 眼痛程度',
    fontproperties=my_font,
    fontsize=14,
    fontweight='bold',
)
axes[1].set_xlabel(
    '是否使用抗藍光濾鏡 (Blue_Light_Filter_Used)',
    fontproperties=my_font,
    fontsize=12,
)
axes[1].set_ylabel('眼痛自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[1].set_xticks([0, 1])  # 先固定刻度消除 UserWarning
axes[1].set_xticklabels(
    ['未開啟 (No)', '使用 (Yes)'], fontproperties=my_font, fontsize=11
)

plt.tight_layout()
plt.show()

# 2. 精確量化:計算兩組的平均數、中位數與標準差
print("=== 抗藍光濾鏡分組指標統計 ===")
group_stats = df.groupby('Blue_Light_Filter_Used')[
    ['Eye_Dryness_Level', 'Eye_Pain_Level']
].agg(['mean', 'median', 'std'])
display(group_stats.round(2))
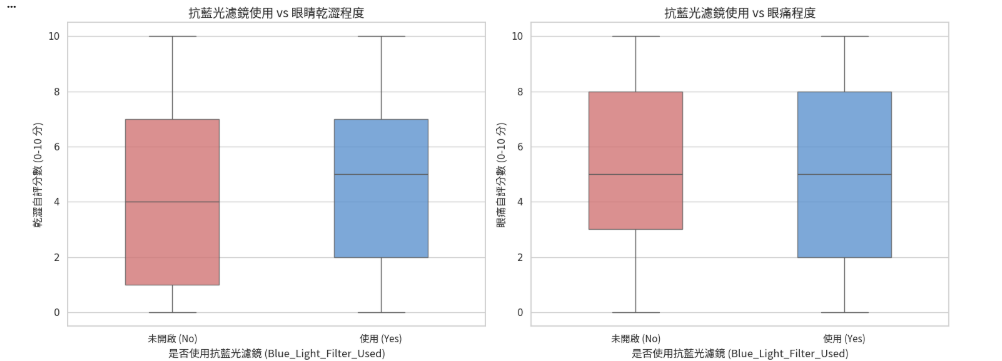

三、圖表解讀與客觀數據分析
由無警告優化版繪製的箱形圖與對應統計表格,可得出具統計意義的客觀結論:
1.眼睛乾澀程度(Eye_Dryness_Level):使用濾鏡組評分未見降低
2.眼痛程度(Eye_Pain_Level):兩組分佈呈現高度重合
四、今日工程收穫與總結


 iThome鐵人賽
 看影片追技術